フェイルオーバー(failover)とは、稼働中のサーバーや機器に障害が起きたとき、待機していた別の機器へ処理を切り替える仕組みのことです。「自動フェイルオーバー」と書かれている場合は、その切り替えを人が操作せず、システムが障害を検知して行うことを指します。この記事では、フェイルオーバーの意味と読み方、仕組み、自動と手動の違い、構成パターン、導入時の注意点を未経験向けに解説します。
フェイルオーバーとは何か
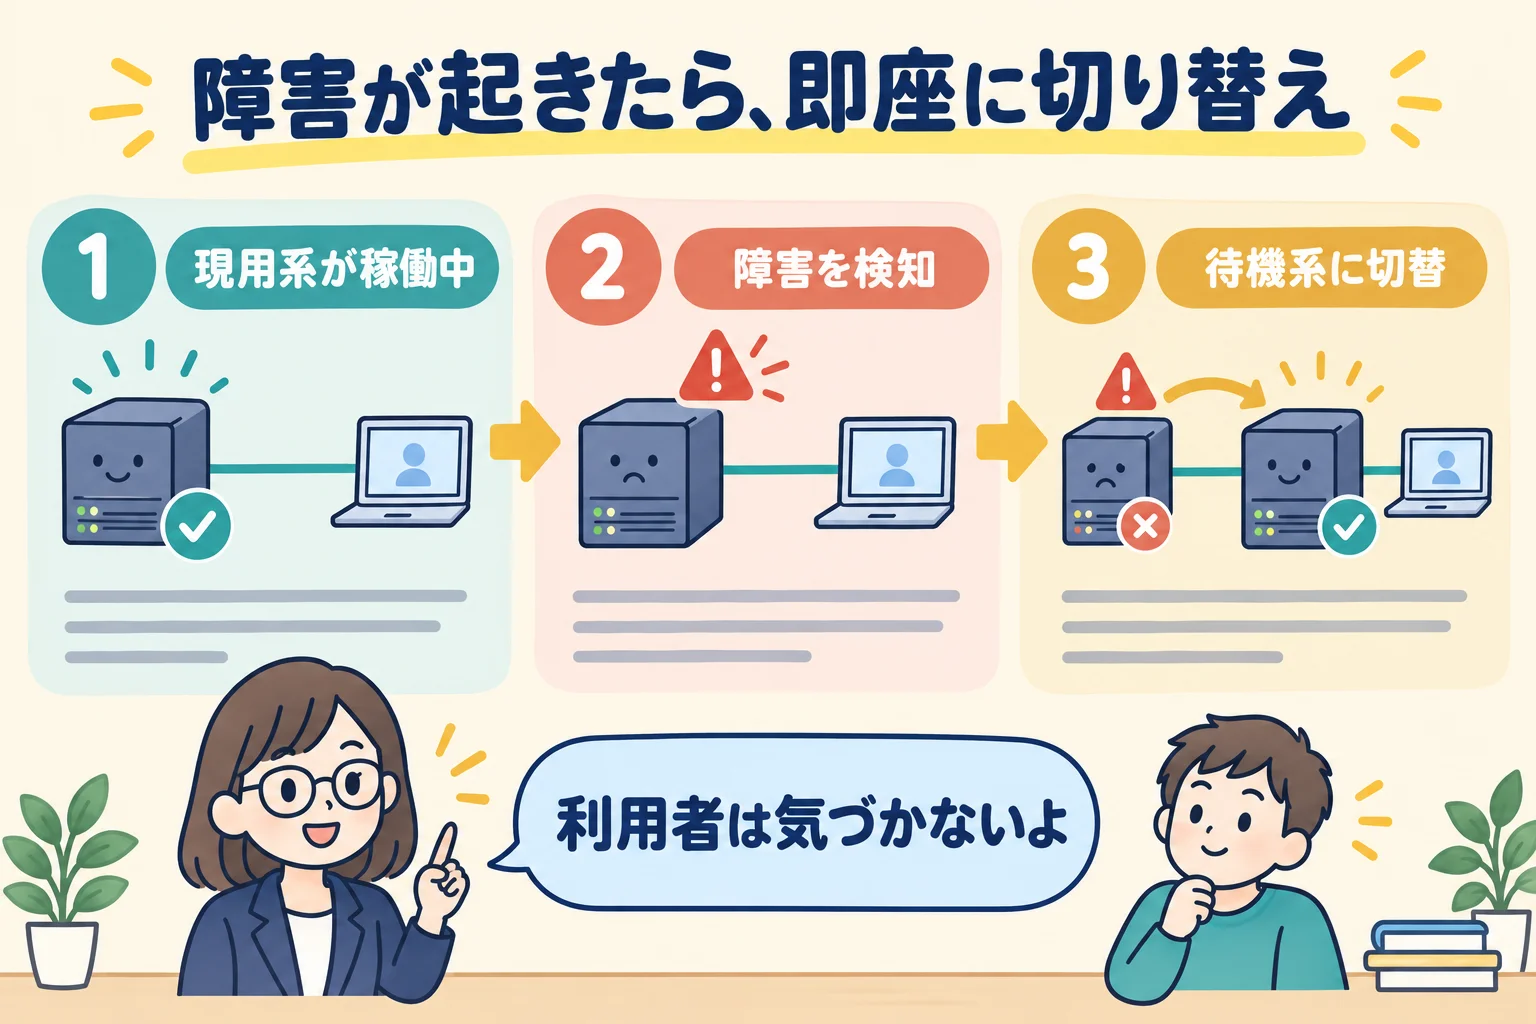
フェイルオーバーは「failover」、つまり「故障(fail)したら乗り換える(over)」という英語がそのまま名前になった仕組みです。普段使っているサーバーやネットワーク機器(本番系・現用系と呼びます)が止まったことを検知すると、同じ役割を持つ別の機器(待機系・スタンバイ系)へ処理を引き継ぎます。利用者からすると、裏側で機器が切り替わったことに気づかないまま、サービスを使い続けられるのが理想の状態です。
この仕組みが成り立つためには、大きく2つの動作が必要です。1つは「現用系が止まったこと」を見つける監視の動作、もう1つは「見つけたあとに実際に待機系へ処理を移す」切り替えの動作です。この2つがセットで動くからこそ、人が気づくより先にシステム側で対応できるようになります。
failover(fail over)の意味と読み方
「fail over」と2語に分けて書かれることもありますが、IT用語としては同じ意味です。読み方は「フェイルオーバー」で、日本語では「障害切り替え」「系切り替え」と呼ぶこともあります。fail は「失敗する・故障する」、over は「別のものへ移る」という意味合いなので、直訳すると「故障したら乗り換える」になります。
似た言葉との違いは次の表のとおりです。
| 用語 | 意味 |
|---|---|
| フェイルオーバー | 障害時に待機系へ処理を切り替える動作 |
| フェイルバック | 復旧後に元の現用系へ処理を戻す動作 |
| スイッチオーバー | 保守作業などのために、人が計画的に系を切り替える動作 |
| 冗長化 | 切り替え先となる同じ役割の機器を複数用意しておくこと |
障害が起きたときに動くのがフェイルオーバー、計画して手で行うのがスイッチオーバーと覚えると、現場の会話が聞き取りやすくなります。
自動フェイルオーバーとは?手動との違い
自動フェイルオーバーは、障害の検知から切り替えまでをシステムが自動で行う方式です。夜間や休日に障害が起きても、人が操作するのを待たずに復旧へ向かえるのが強みです。
一方、手動フェイルオーバーは、障害の通知を受けた担当者が状況を確認し、手順に沿って切り替えを実行する方式です。切り替えが遅れる代わりに、誤検知による不要な切り替えを避けやすく、データのずれも確認してから動けます。
- 自動: 切り替えが速い。誤検知のときに不要な切り替えが起きるリスクがある
- 手動: 判断を人が挟めるので慎重に動ける。切り替えまでに時間がかかる
どちらを選ぶかは、サービスがどれだけ止まってはいけないか、データのずれがどれだけ許されるかで決まります。
仕組み: 冗長化があってはじめて成立する
フェイルオーバーを理解するうえで欠かせないのが、冗長化という考え方です。冗長化とは、同じ役割の機器やシステムを複数用意しておくことを指します。つまり冗長化は「切り替え先を用意すること」、フェイルオーバーは「実際に切り替える動作」という役割分担になっています。冗長化されていなければ、そもそも切り替え先の機器が存在せず、フェイルオーバーは機能しません。
監視の仕組みとしては、定期的に機器へ信号を送って応答があるかを確認する方法がよく使われます。応答が一定回数途切れると「障害が起きた」と判断し、切り替えの動作に移ります。この判断が早すぎると誤検知につながり、遅すぎると利用者が影響を受ける時間が延びてしまうため、どのくらいの間隔で確認するかの設計も重要なポイントになります。
よくある構成例
現場でよく見かける構成を整理すると、次のようなパターンがあります。
- サーバー二重化: 同じ構成のサーバーを2台用意し、現用系が止まったら待機系へ切り替える
- ロードバランサー経由の切り替え: ロードバランサーが機器の死活状態を監視し、異常を検知したサーバーへの振り分けを止める
- ディスクの冗長化: RAIDのように、ディスク1台が壊れてもデータが失われないようにする
- リージョン・AZをまたぐ冗長化: AZを分けて配置し、1つのデータセンターの障害でも止まらないようにする
どの構成でも共通しているのは、「障害を検知する仕組み」と「切り替え先の機器」の両方がセットで用意されている点です。
待機系の持ち方には、大きく2つの考え方があります。
- アクティブ・スタンバイ: 普段は現用系だけが処理し、待機系は控えている。障害時に待機系が処理を引き継ぐ
- アクティブ・アクティブ: 複数台が普段から同時に処理していて、1台が止まったら残りが肩代わりする
アクティブ・アクティブは待機系の機器を遊ばせない一方、1台が抜けても残りで処理しきれる余裕を持たせておく必要があります。災害のような大規模な障害への備えまで広げて考えたい場合は、ディザスタリカバリの記事も参考になります。
メリットと注意点
フェイルオーバーを導入する一番のメリットは、サービスの停止時間を短くできることです。待機系への切り替えが数秒〜数十秒で完了する構成であれば、利用者が気づかないうちに障害から復旧できる場合もあります。
一方で、注意しておきたい点もあります。
- 切り替え判定の誤検知: 実際には障害が起きていないのに切り替わってしまい、逆に不安定になることがある
- データの整合性: 現用系と待機系でデータがずれていると、切り替え後に古いデータが見えてしまう場合がある
- コスト: 待機系の機器を普段から用意しておく必要があるため、構成がシンプルな場合に比べて費用がかさみやすい
こうした注意点があるため、どこまで自動で切り替えるか、どこから人が判断するかの線引きは、システムの重要度に応じて現場ごとに設計されています。すべてを自動化すれば良いというわけではなく、誤検知が起きたときの影響度も含めて、どの範囲まで任せるかを決めておく必要があります。
現場で感じること
現役でインフラの現場にいる立場から言うと、フェイルオーバーの設定自体は一度組んでしまえば動き続けるものの、「本当に想定どおり切り替わるか」を定期的に確認しておくことがとても大切だと感じています。実際に障害が起きてから初めて切り替えを試す、という状態は避けたいところです。切り替え訓練を定期的に行っている現場ほど、本番の障害でも落ち着いて対応できている印象があります。設定した直後だけでなく、機器の構成を変えたときにも同じ切り替えが働くかを確認しておくと、後からの事故を減らせます。
フェイルオーバーと似た言葉として「フェイルバック」もあります。これは、障害が解消して現用系が復旧したあと、処理を待機系から元の現用系へ戻す動作を指します。切り替えたあとに戻し忘れると、待機系に負荷がかかり続けてしまうため、フェイルバックの手順も合わせて決めておくことが大切です。
InfraDojoで学ぶ
InfraDojoなら、ブラウザ上の演習環境でロードバランサーやネットワークの基礎を手を動かしながら学べるため、フェイルオーバーの前提になる冗長化の考え方も理解しやすくなります。ネットワークの基礎から順番に学びたい場合は、ネットワーク学習ロードマップを確認してみてください。
よくある質問
Q. フェイルオーバーとフェイルセーフは何が違いますか?
フェイルオーバーは障害発生時に別の機器へ処理を切り替える仕組みです。フェイルセーフは、障害が起きたときにシステム全体が安全な状態(止まる、制限されるなど)になるようにする考え方で、目的が少し異なります。
Q. フェイルオーバーは必ず自動で行われますか?
自動で切り替わる構成が多いですが、重要度の高いシステムでは、自動検知のあとに人が最終確認をしてから切り替える運用もあります。どこまで自動化するかはシステムの性質によって変わります。
Q. failover と fail over は同じ意味ですか?
同じ意味です。英語では動詞句として fail over、名詞や形容詞として failover と書き分けることがありますが、IT用語としてはどちらも障害時に別の機器へ切り替えることを指します。
Q. 自動フェイルオーバーを設定すれば、障害でサービスが止まらなくなりますか?
停止時間を短くできる仕組みですが、切り替わるまでの短い間は影響が出る場合があります。また、待機系自体が壊れていたり、データがずれていたりすると期待どおりに動きません。定期的な切り替え確認が欠かせません。
Q. 未経験でもこの仕組みを理解しておくべきですか?
名前と大まかな仕組みだけ知っておけば十分です。現場に入ってから、監視や冗長化構成の設計に触れる中で、実際の切り替え動作を学ぶ機会が出てきます。