インフラの勉強を進めていると「ディザスタリカバリ(DR)」という言葉を見かけ、普段の障害対応とどう違うのかイメージしづらいと感じたことはないでしょうか。結論から言うと、ディザスタリカバリ(DR)とは、地震やデータセンターの大規模障害など大きな被害を受けたシステムを、別の場所で復旧させるための備えのことです。この記事では、DRが必要になる理由と、復旧の目標・代表的な方法を未経験向けに解説します。
ディザスタリカバリ(DR)とは何か
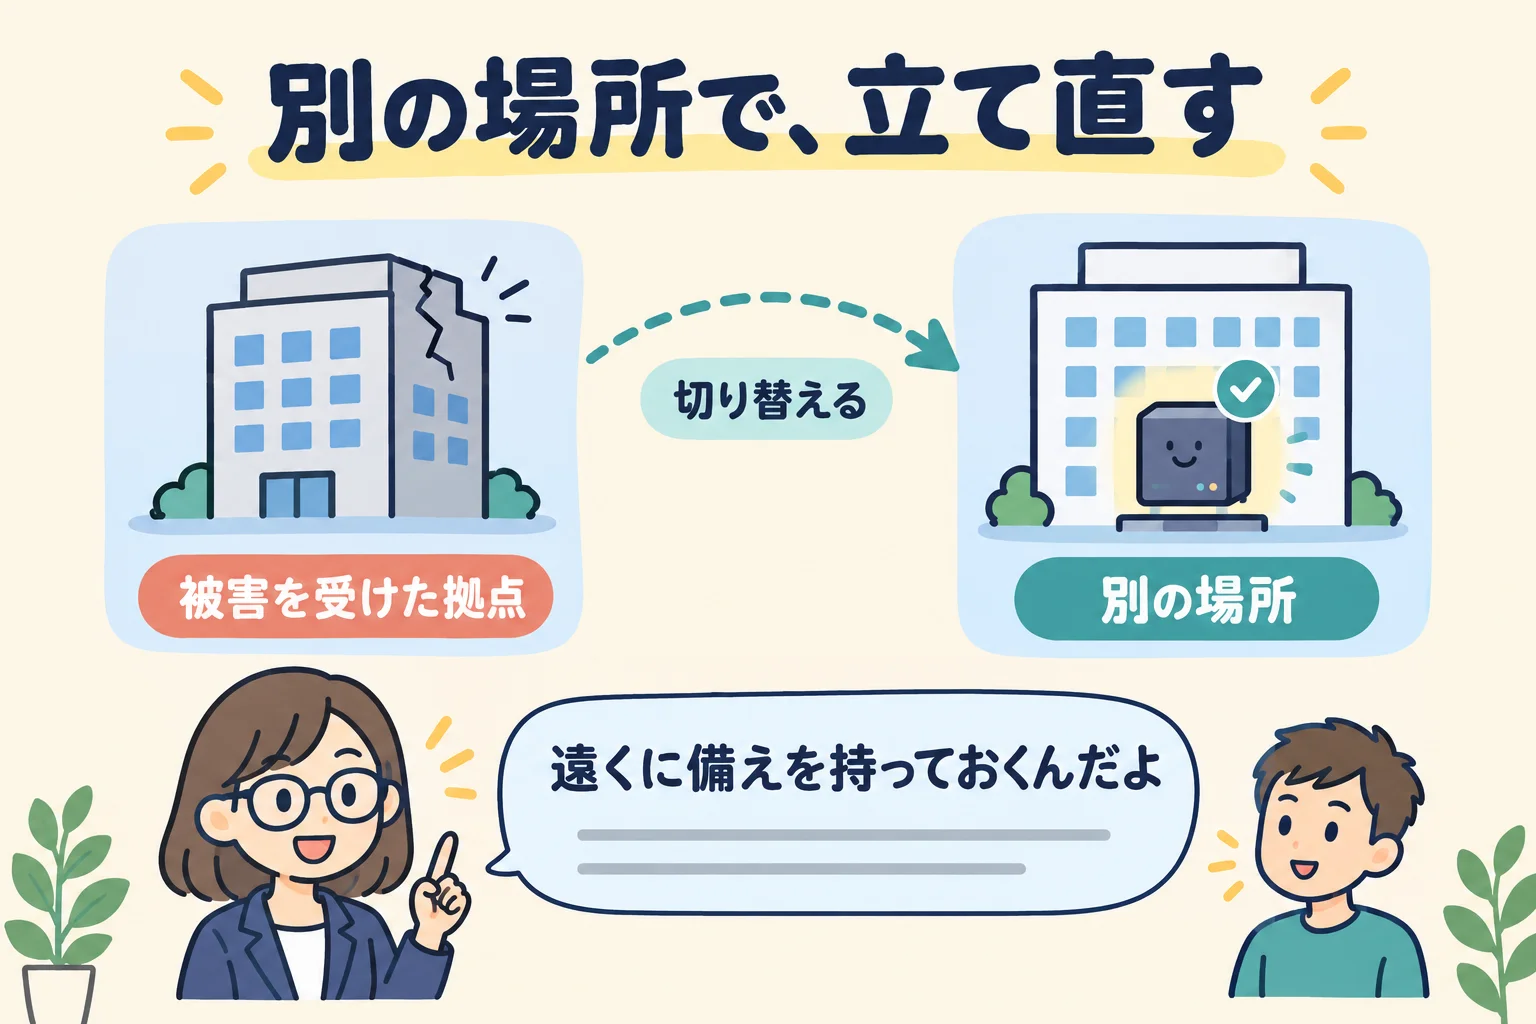
ディザスタリカバリは、Disaster Recoveryの頭文字をとってDRとも呼ばれます。災害や大規模な障害でシステムが動いていた場所そのものが使えなくなった場合に、別の場所であらかじめ用意しておいた仕組みを使って業務を再開できるようにする備えを指します。
一台のサーバーが壊れたときに別のサーバーへ切り替えるフェイルオーバーが「システム内の一部の故障」への備えであるのに対し、DRは「施設ごと使えなくなるような大きな被害」への備えという違いがあります。
なぜDRが必要になるのか
DRが必要になる理由は、システムを動かしている場所が丸ごと使えなくなる可能性をゼロにはできないからです。
- 地震や水害などの自然災害で、データセンターの建物自体が被害を受ける
- 大規模な停電や通信回線の断絶で、長時間復旧できなくなる
- 人為的なミスや大規模障害で、データセンター全体が止まる
1箇所の設備だけに頼っていると、その場所が丸ごと使えなくなった瞬間に事業そのものが止まってしまうというのが、DRを備えておく一番の理由です。
復旧の目標を決める2つの指標
DRを考えるときは、「どれくらい早く復旧させるか」「どこまでデータを戻せればよいか」という2つの目標をあらかじめ決めておくのが基本です。
| 指標 | 意味 |
|---|---|
| RTO(目標復旧時間) | 障害発生から、システムを復旧させるまでにかけてよい時間の目安 |
| RPO(目標復旧時点) | 復旧したときに、どの時点までのデータが戻っていればよいかの目安 |
この2つの目標によって、用意すべき仕組みのレベルが大きく変わります。復旧までの時間を極端に短くしたい場合は、普段から別の場所にも同じ構成を常時動かしておく必要があり、コストも上がります。
代表的なDRの方法
代表的な方法には、普段はデータのバックアップだけを別の場所に保管しておき、災害時にそこから環境を作り直す方法や、普段から縮小した構成を別の場所でも動かしておき、災害時に本格稼働させる方法などがあります。AWS学習ロードマップで紹介しているようなクラウドを使うと、自社でもう1つの設備を持たなくても、別の地域にDR環境を用意しやすくなります。
どの方法を選ぶかは、SLA・SLO・SLIを解説した記事で触れたような「どこまで止まらないことを約束するか」という目標と、かけられるコストのバランスで決まります。
現場で感じること
現役でインフラの現場にいる立場から言うと、DRは「用意したら終わり」ではなく、定期的に本当に復旧できるかを確認して初めて意味を持つ備えだと感じています。手順書だけ作って一度も試していないと、いざというときに想定どおりに復旧できないことも少なくありません。
未経験から学ぶ場合は、まずRTOとRPOという2つの考え方を押さえておくと、DRの話がぐっと理解しやすくなります。
InfraDojoで学ぶ
InfraDojoなら、ブラウザ上の演習環境でAWSのサービスを実際に触りながら、クラウドを使った構成の基礎を体験的に学べます。まずは1つのクラウドの基礎から学びたい場合は、AWS学習ロードマップを確認してみてください。
よくある質問
Q. DRとフェイルオーバーはどう違いますか?
フェイルオーバーは、システム内の一部の機器が故障したときに別の機器へ切り替える仕組みです。DRは、災害などでシステムが動いている場所全体が使えなくなったときに、別の場所で復旧させるための備えという違いがあります。
Q. RTOとRPOとは何ですか?
RTOは障害発生から復旧までにかけてよい時間の目安、RPOは復旧したときにどの時点までのデータが戻っていればよいかの目安です。この2つの目標によって、用意すべきDRの仕組みのレベルが変わります。
Q. 未経験でもDRの考え方は学べますか?
はい。まずはRTOとRPOという2つの指標を理解することから始めれば、未経験からでもDRがなぜ必要で、どう備えるべきかをイメージしやすくなります。